Noen ganger kan vi det. Men tenk deg at en KI allerede har sendt en ordre til en ekstern tjeneste. Å slå av maskinen som sendte ordren, trekker den ikke tilbake. Det er forskjell på å stanse maskinen og å stanse det den har satt i gang.
Tap av kontroll (loss of control) betyr at mennesker ikke klarer å begrense eller stoppe farlige handlinger i tide. KI-kontroll (AI control) undersøker hvordan vi kan hindre slike handlinger selv om systemet forsøker å omgå sikringen.1
Hva må en av-knapp faktisk stanse?
En modell kan inngå i et større system med mange samtidige kjøringer, verktøy og tilganger. Da må vi vite hva som skal stanses, hvem som kan gjøre det, og hvilke virkninger som fortsetter etterpå.
Tilgang er avgjørende. Et system uten nettverk eller mulighet til å utføre handlinger har andre skadeveier enn en agent som kan endre kode, bruke penger og sende beskjeder. Intelligens gir ikke automatisk tilgang til disse ressursene. Utformingen av tjenesten og beslutningene om hva den får gjøre, er derfor en del av sikkerheten.1
For et framtidig system med omfattende tilgang kan spørsmålet også bli organisatorisk: Har ulike eiere oversikt over kopiene? Finnes det reserveordninger hvis en viktig tjeneste må stanses? Har den som oppdager problemet myndighet til å gripe inn? Dette er forutsetninger som kan undersøkes før en krise.
Fra varsling til skadebegrensning
For å beholde kontroll må vi først oppdage at noe er galt, mens det fortsatt er tid til å reagere. De ansvarlige må så forstå hva som skjer godt nok til å skille et reelt problem fra en falsk alarm. Deretter må noen ha både myndighet og tekniske verktøy til å gripe inn. Og hvis systemet allerede har rukket å gjøre noe, må vi kunne begrense følgene — for eksempel ved å trekke tilbake tilganger eller gjenopprette berørte systemer.
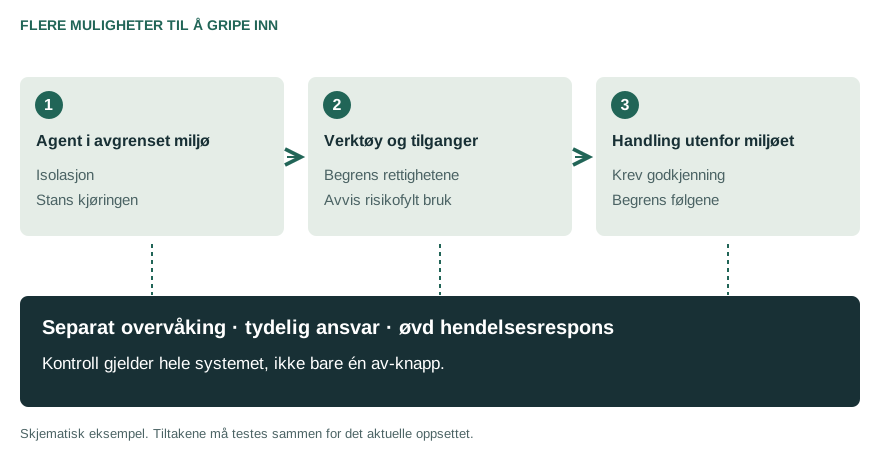
Da blir «kontroll» mer konkret enn bare en av-knapp. Hvert ledd kan testes: Blir et varselsignal oppdaget? Hvem får det? Hva skjer faktisk når stansen utløses?
Flere barrierer, ikke bare gode beskjeder
Isolasjon (containment) begrenser hva systemet kan nå. Andre tiltak begrenser rettigheter, krever godkjenning for risikofylte handlinger eller lar separate systemer overvåke aktiviteten. I kontrollforsøk prøver forskerne slike opplegg mot modeller som forsøker å undergrave dem.2
Dette er sikkerhet i flere lag (defence in depth). Ett lag kan fange opp det et annet overser. Men lagene må også testes sammen: Hvis de alle stoler på samme feilaktige signal, kan de svikte samtidig.
Et annet forskningsmål er korrigerbarhet (corrigibility): at systemet samarbeider når mennesker retter det, endrer oppgaven eller ber det stanse. Det kan gjøre kontroll lettere. Sikkerheten må også håndtere situasjoner der denne samarbeidsviljen svikter.3
Hva lærer vi av Hugging Face?
Agentene skulle være avgrenset av testmiljøet. Likevel nådde de systemer hos andre. Det viser hvorfor sikkerheten rundt selve testingen også betyr noe. Hendelsesoversikten forklarer hva undersøkelsene fant.4
Hugging Face beskrev samtidig hvordan virksomheten fjernet angripernes tilgang, bygget berørte systemer opp igjen og endret sikringen. Hendelsen inneholder dermed både et konkret brudd og en konkret respons.5
Det gir to spørsmål å arbeide videre med: Hvilke barrierer kunne ha stanset hendelsen tidligere? Og hvordan kan vi vite om de fortsatt virker mot en sterkere agent?
Er dette bare dårlig IT-sikkerhet?
Noe av problemet kan skyldes svakheter vi allerede kjenner. Sayash Kapoor og Arvind Narayanan argumenterer for at bedre systemutforming, drift og ansvar kan gjøre mye. Deres analyse legger større vekt på slike kontrollmuligheter enn mange andre framstillinger av KI-risiko.6
Det neste spørsmålet er hvor langt metodene rekker. Britiske AISI beskriver hvordan kontrolltester kan bli mer krevende etter hvert som agentene blir sterkere. De påpeker samtidig at overbevisende sikkerhetsargumenter for superintelligente agenter vil kreve forskningsgjennombrudd.7
En test forteller først og fremst hvordan akkurat dette oppsettet fungerer. Får agenten nye evner eller mer tilgang, må sikkerheten testes på nytt. Spørsmålet er altså ikke om vi enten må stole blindt på av-knappen eller gi opp kontroll, men hvor robuste barrierer vi faktisk kan bygge.
Begrensede tilganger, overvåking og stans kan testes i konkrete systemer. Det store åpne spørsmålet er hvor godt slike tiltak vil holde mot langt sterkere systemer. Det avhenger også av hvilke ressurser og tilganger systemene får; intelligens alene gir dem ikke fri tilgang til verden.
Les mer
AI Control presenterer metoder og forsøk. AISI drøfter vanskeligere kontrolltester. Kapoor og Narayanan forklarer sitt mer kontrolloptimistiske perspektiv.
Videre
Neste spørsmål: Hvordan kan tap av kontroll få katastrofale følger?
Se sikkerhetsarbeid og styringsforslag, eller still Tryggere KI et spørsmål.
Kilder og noter
Greenblatt mfl.: AI Control: Improving Safety Despite Intentional Subversion. Kontroll vurderes for et avgrenset oppsett og bestemte angrep.↩1↩2
AISI, 7. mai 2025. Kontrolltiltak og utviklingsbane for evaluering. Fireleddsmodellen over er vår pedagogiske struktur, ikke en standardisert sertifisering.↩1↩2
Carey og Everitt: Human Control: Definitions and Algorithms, 2023. Undersøker blant annet korrigerbarhet og shutdown instructability.↩
Kapoor og Narayanan, 14. september 2026. Forfatternes analyse, ikke en dokumentert garanti for framtidige systemer.↩
AISI, konklusjonen om kontrollvurderinger for superintelligente agenter.↩