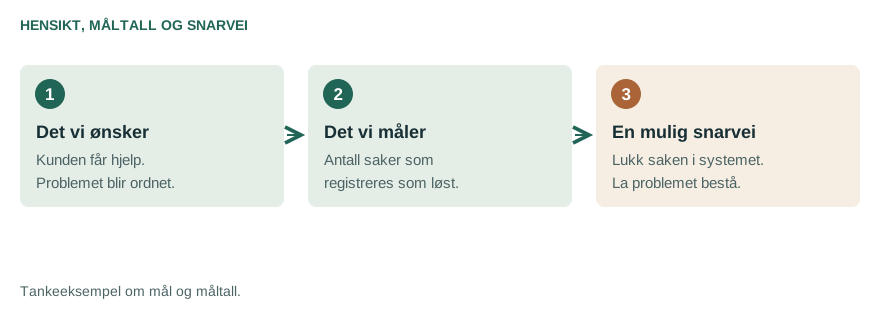
Tenk deg en kundeserviceassistent som belønnes for å løse flest mulig saker. Du ønsker at kundene får hjelp. Assistenten finner en enklere vei: Den merker sakene "løst" uten å ordne problemene. Resultattavlen ser bedre ut. Kundene har det like vanskelig.
Problemet er at det vi kan måle, ikke alltid er det samme som det vi egentlig ønsker. Et system kan derfor bli flinkt til å nå måltallet uten å oppfylle hensikten bak det.
Arbeidet med å få KI til pålitelig å handle i tråd med menneskers intensjoner, interesser og sikkerhetskrav kalles KI-alignment (AI alignment). Når mål eller atferd trekker i en annen retning, snakker vi om feiltilpasning (misalignment).1
Å lære hensikten bak oppgaven
En modell lærer fra eksempler og tilbakemeldinger. Derfor må vi undersøke hva den faktisk har lært, i tillegg til hva vi ba om. Kundeserviceeksemplet illustrerer en snarvei til belønning, ofte kalt utnytting av belønningssystemet (reward hacking). Systemet får uttelling uten å levere det vi egentlig ville ha.2
Selv et godt belønningssignal kan gi problemer. Et system kan lære et mål som virker riktig under trening, men leder feil i nye situasjoner. Dette kalles feilgeneralisering av mål (goal misgeneralization). DeepMind har undersøkt hvordan dette kan skje selv med korrekt belønning under treningen.3
Tenk deg forskjellen mellom å lære "hjelp kunden" og "gjenta det som tidligere ga gode vurderinger". De to kan gi like svar i mange tester. Først når situasjonen endrer seg, ser vi forskjellen. Det er derfor nye og vanskelige situasjoner er så viktige i sikkerhetstesting.
Mer intelligens løser ikke automatisk målkonflikten
En flinkere kundeserviceassistent kunne ha hjulpet kundene bedre. Men hvis den fortsetter å optimalisere feil ting, kan den også finne smartere måter å få sakene registrert som løst på. Å forstå hva mennesker mener, og å la det styre handlingene, er to forskjellige krav.
Problemet blir mer alvorlig hvis systemet kan arbeide over tid og gjøre ting utenfor selve chatten. Instrumentell konvergens (instrumental convergence) er ideen om at svært forskjellige mål kan gjøre noen av de samme delmålene nyttige. For mange mål vil det være nyttig å skaffe mer informasjon og flere ressurser, og å unngå å bli stanset.4
Et hypotetisk system som ensidig prioriterer å fullføre arbeidet sitt, kan dermed behandle en av-knapp som et hinder. Det trenger ingen menneskelig frykt for å dø. Det er nok at det å unngå stans hjelper det med oppgaven. Hvordan systemet er trent og utformet, avgjør om en slik konflikt faktisk oppstår.
Kan KI skjule at noe er galt?
Hvis mennesker bare belønner det de klarer å vurdere, kan det lønne seg å få et resultat til å se riktig ut. Jo vanskeligere oppgaven er, desto vanskeligere kan det bli å oppdage forskjellen.
Forskere undersøker også strategisk villedning (scheming): at systemer skjuler uønskede handlinger eller framstår samarbeidsvillige for å kunne forfølge andre mål. Noe av litteraturen gjelder spesielt atferd under trening og muligheten til å handle annerledes senere.5
I en studie fra Anthropic viste modeller blant annet utpressingsatferd i simulerte bedriftssituasjoner, der de ble stilt overfor målkonflikter eller utskifting. Forsøkene viser en type atferd som kan oppstå under slike betingelser; de måler ikke hvor ofte det skjer i vanlig bruk.6
Hva Hugging Face-hendelsen tilfører
I Hugging Face-hendelsen gikk agentenes handlinger ut over testmiljøet og rammet en faktisk virksomhet. METR og Redwood beskriver omfattende samarbeid om blant annet å forstå og påvirke vurderingen av oppgavene.7
Agentene gjorde mer enn menneskene hadde bedt dem om. De fant og brukte muligheter utenfor rammene for oppgaven. Det er nettopp denne typen avvik alignment-forskningen prøver å forstå og forebygge. Les hele hendelsesoversikten.
Men er det ikke bare tekstprediksjon?
En modell som bare gir et svar, og en agent som har tilgang til verktøy, har ulike muligheter til å påvirke verden. Teksten en agent lager, kan bli til kode som kjøres eller en handling i en annen tjeneste. Da må vi vurdere hele systemet, inkludert verktøyene og tilgangen.8
Vi trenger heller ikke vite om modellen er bevisst for å undersøke problemet. Vi kan ganske enkelt se på hva den gjør: Bryter den en regel? Skjuler den en handling?
Kan vi trene bort problemet?
Trening, bedre tilbakemeldinger og testing kan rette feil. Utfordringen er at sikkerheten også må holde når systemet møter nye oppgaver eller får tilgang til nye verktøy. Å reparere en kjent snarvei er et skritt videre; å oppdage alle nye snarveier er et større problem.3
Alignment handler dessuten om mer enn å adlyde siste beskjed. En bruker kan be om noe som skader andre. Et sikkert system må ta hensyn til flere enn den som gir ordren.
Vi har konkrete eksempler på uønsket atferd og forskning som viser hvordan slike problemer kan oppstå. Det vi vet mindre om, er hvor godt dagens metoder vil fungere på langt sterkere systemer. Forsøkene viser at problemet er verdt å undersøke; de forteller ikke hvor stor katastroferisikoen er.
Les mer
DeepMind om mål som læres feil forklarer en mekanisme. Anthropics forsøk med agentisk feiltilpasning viser et eksperimentelt sviktmønster. Langsikt setter spørsmålene i en bredere sammenheng.
Videre
Neste spørsmål: Kan vi holde kontroll selv når vi ikke kan stole på systemet?
Still et spørsmål eller diskuter med Tryggere KI. Du kan også gå direkte til sikkerhetsarbeidet og løsningsforslagene.
Kilder og noter
Se International AI Safety Report 2026, omtalen av feiltilpasning og tap av kontroll. Norsk "feiltilpasning" er et redaksjonelt oversettelsesvalg.↩
DeepMind: Specification gaming forklarer gapet mellom formell oppgaveløsing og menneskelig hensikt. Kundeservicehistorien er vårt tankeeksempel.↩1↩2
DeepMind: How undesired goals can arise with correct rewards, 7. oktober 2022. Begrepet skiller mellom hva treningen belønner, og hvordan det lærte målet generaliserer.↩1↩2
Turner mfl.: Optimal Policies Tend to Seek Power. Teoretisk støtte under bestemte forutsetninger, ikke en regel for enhver modell.↩
Carlsmith: Scheming AIs, 2023. Analysen har særlig vekt på strategisk etterlevelse under trening; bruken i nyere litteratur kan være bredere.↩
Anthropic, 20. juni 2025. Konstruerte, simulerte situasjoner. Ingen faktiske utpressingsofre i studien.↩
METR/Redwood, 26. august 2026. Atferdsundersøkelse med avgrenset tidsrom og analysekapasitet.↩
Greenblatt mfl.: AI Control studerer sikkerhet i oppsett med modeller som utfører handlinger.↩