KI har tatt store steg på krevende oppgaver. Det ser vi i matematikkresultater og i tester av lengre programvareoppgaver. Men et system kan samtidig være upålitelig i praktisk arbeid. Her ser vi både på fremgangen og på hvor langt det er fra en imponerende testprestasjon til et system vi kan stole på i praksis.
Det et system kan gjøre, kalles dets evner eller kapabiliteter (AI capabilities).
Tre matematikkmilepæler
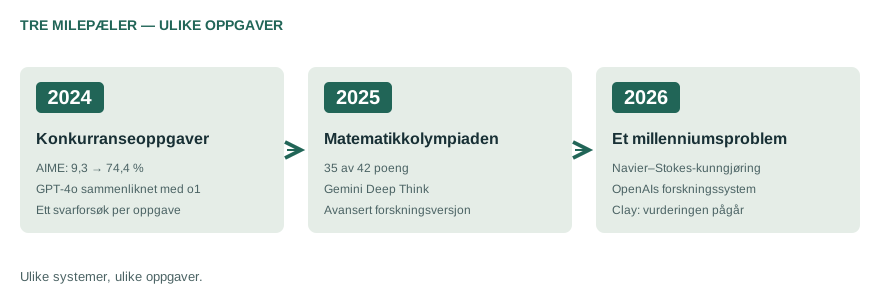
Dette er tre forskjellige oppgaver, så de kan ikke leses som én sammenhengende resultatkurve. For å se endring mer direkte trenger vi også tester der oppgaven er den samme.
Et sprang på samme test
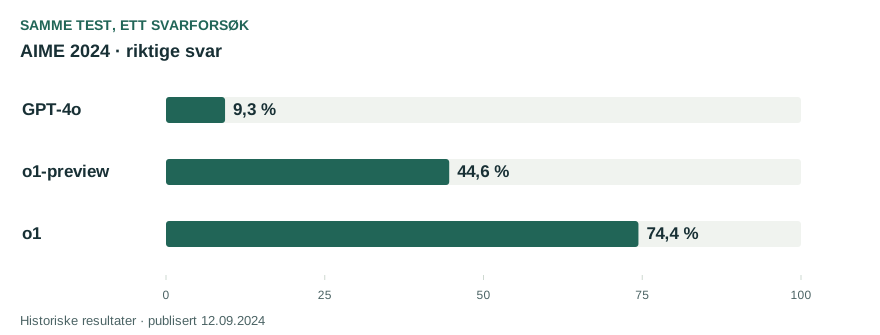
AIME er en krevende matematikkonkurranse for skoleelever. På akkurat dette oppgaveutvalget gikk resultatet fra 9,3 prosent med GPT-4o til 74,4 prosent med o1; o1-preview lå mellom dem med 44,6 prosent. På denne testen gikk o1 fra GPT-4os 9,3 prosent til 74,4 prosent. Det er en påminnelse om at det KI er dårlig til i dag, ikke nødvendigvis er en varig begrensning.
Lengre oppgaver: en faktisk måleserie
En KI-agent (AI agent) kan bruke verktøy og arbeide i flere steg: skrive kode, kjøre den, lese feilmeldingen og prøve igjen. METR undersøker hvor omfattende programvareoppgaver slike systemer mestrer. METR måler hvor lange oppgaver en KI-agent klarer å løse, der lengden er hvor lang tid en menneskelig fagperson vanligvis trenger på samme oppgave. METR kaller dette task-completion time horizon.4
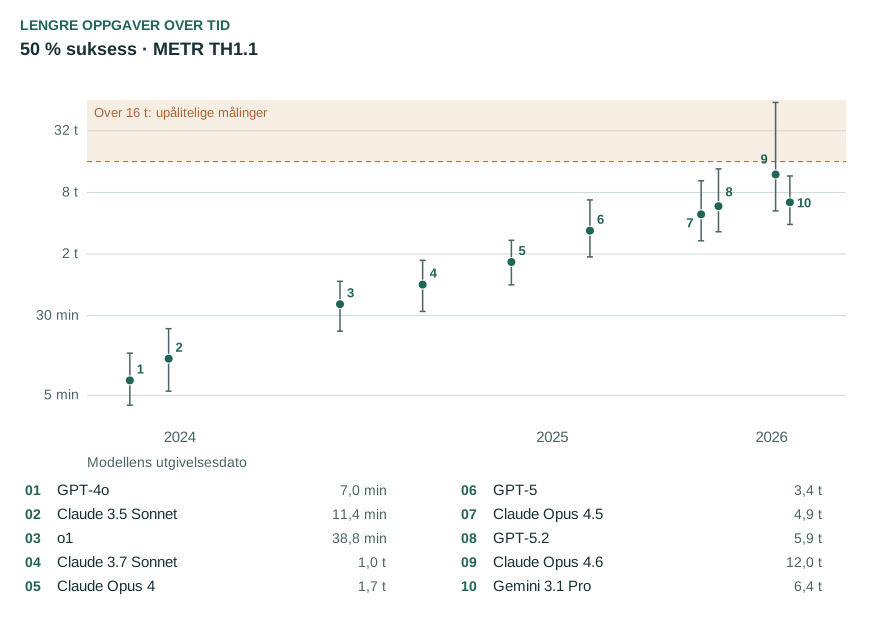
I utvalget ligger GPT-4o rundt sju minutter, GPT-5 rundt 3,4 timer og Claude Opus 4.6 rundt 12 timer. Det siste anslaget har et svært bredt intervall. Gemini 3.1 Pro, som ble utgitt senere, ligger rundt 6,4 timer. Dette er derfor ingen jevn stige der hver ny modell er bedre enn den forrige.5
En 50-prosenthorisont betyr at modellen anslås å lykkes halvparten av gangene rundt dette oppgaveomfanget. Det er menneskets oppgavetid, ikke hvor lenge KI-en selv arbeider. Utvalget er heller ikke en full oversikt over modellene som finnes i september 2026.
Pålitelighet endrer bildet
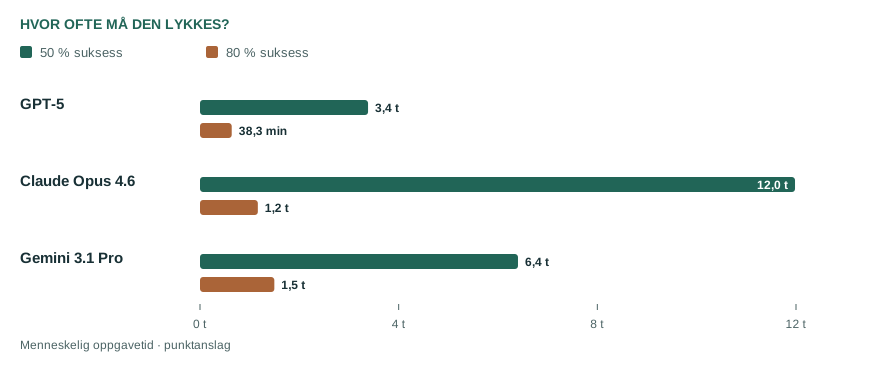
Å klare en vanskelig oppgave av og til er nyttig. Men det er noe annet enn å kunne overlate oppgaven til systemet og være rimelig sikker på at den blir løst riktig. Begge målene er relevante når vi vurderer hva en agent kan gjøre.
Se tallene bak METR-grafene
Alle tider i tabellen er minutter med menneskelig oppgavetid. Tallene er avrundet til én desimal her; figurene bruker de uavrundede verdiene. Parentesene viser de rapporterte intervallene. Utvalget dekker en lengre periode og flere leverandører, men ikke alle modeller.5
| Modell og utgivelse | 50 % suksess (intervall) | 80 % suksess (intervall) |
|---|---|---|
| 1. GPT-4o · 2024-05-13 | 7,0 (4,0–12,9) | 1,3 (0,6–3,0) |
| 2. Claude 3.5 Sonnet · 2024-06-20 | 11,4 (5,5–22,4) | 1,7 (0,6–4,6) |
| 3. o1 · 2024-12-05 | 38,8 (21,2–65,0) | 7,1 (3,0–16,6) |
| 4. Claude 3.7 Sonnet · 2025-02-24 | 60,4 (33,0–104,2) | 12,1 (4,6–28,9) |
| 5. Claude Opus 4 · 2025-05-22 | 100,4 (60,0–163,5) | 20,4 (8,5–41,9) |
| 6. GPT-5 · 2025-08-07 | 203,0 (112,6–405,6) | 38,3 (19,2–70,1) |
| 7. Claude Opus 4.5 · 2025-11-24 | 293,0 (161,7–623,7) | 49,4 (20,7–104,6) |
| 8. GPT-5.2 · 2025-12-11 | 352,2 (198,1–815,2) | 66,0 (31,7–131,7) |
| 9. Claude Opus 4.6 · 2026-02-05 | 718,8 (316,7–3633,8) | 69,9 (27,0–170,4) |
| 10. Gemini 3.1 Pro · 2026-02-19 | 384,1 (233,5–694,8) | 89,8 (52,0–158,6) |
Fra laboratoriet til faktisk arbeid
Et testsett (benchmark) kan sammenlikne bestemte ferdigheter under ryddige betingelser. Faktisk arbeid har gjerne utydelige krav, avhengigheter og mye bakgrunnskunnskap. Derfor trenger vi også undersøkelser av om KI gjør mennesker mer effektive i arbeidsoppgavene deres.
I en randomisert METR-studie publisert i juli 2025 arbeidet 16 erfarne utviklere med 246 oppgaver i kodebaser de kjente godt. Med datidens KI-verktøy brukte de i gjennomsnitt 19 prosent lengre tid. Det var et resultat for dette oppsettet, disse utviklerne og verktøy fra tidlig 2025.6
I februar 2026 beskrev METR oppfølgingsarbeid som tydet på at nyere verktøy kunne hjelpe mer. Men hvem som deltok, hvilke oppgaver som kom med, og hvordan tid ble målt, skapte skjevheter. Forskerne kunne derfor ikke gi et robust, direkte sammenliknbart anslag på hvor stor forbedringen var.7
Dette motsier ikke at modeller kan bli bedre på tester. Det viser hvorfor tre spørsmål må holdes fra hverandre: Hva klarer modellen? Hvor ofte klarer den det? Hva skjer når den brukes i virkelig arbeid?
Hvorfor er KI både imponerende og klønete?
Store forskjeller mellom oppgavetyper omtales som ujevne evner (jagged capabilities, eller jaggedness). Skillet mellom lett og vanskelig for KI følger ikke alltid vår intuisjon.8
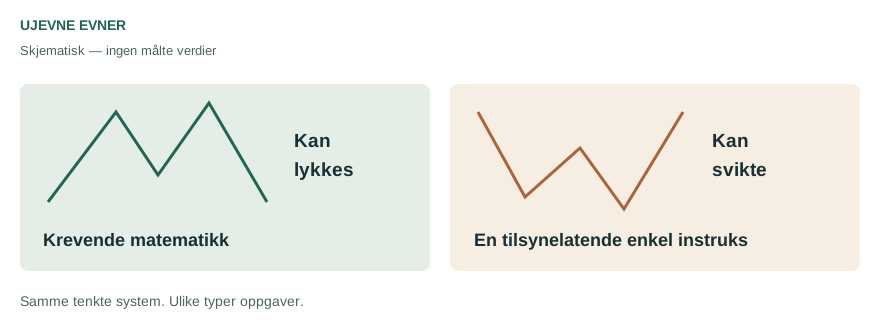
For sikkerhet er spørsmålet derfor mer konkret enn om KI er «smartere enn oss». Kan den for eksempel finne digitale sårbarheter og følge opp et angrep? En slik styrke kan være viktig selv om systemet fortsatt gjør andre, lett synlige feil. Vi må undersøke evnene som trengs for den aktuelle handlingen.
Hvorfor skulle utviklingen stoppe ved oss?
Menneskelig nivå er et naturlig sammenlikningspunkt, men ingen påvist teknisk grense. Digitale systemer kan blant annet kjøres i mange kopier og arbeide parallelt. Hvor mye det hjelper, avhenger av oppgaven og av kostnader, data, maskinvare og kvalitetssikring.9
Automatisering av KI-forskning og -utvikling (AI R&D automation) betyr at KI overtar deler av arbeidet med neste generasjon systemer. OpenAI har beskrevet slik bruk i eget forskningsarbeid.10
Rekursiv selvforbedring (recursive self-improvement, RSI) er ideen om en tilbakekobling: Bedre KI bidrar til bedre KI-forskning, som igjen gir bedre KI. En svært rask akselerasjon gjennom en slik sløyfe omtales som en mulig intelligenseksplosjon (intelligence explosion).11
Å skrive mer kode er likevel bare en del av forskning. Ideene må testes og resultatene må virke. Eksperimenter, databrikker og kvalitetskontroll kan bli flaskehalser selv om andre deler går fort.
Hvorfor spriker fremtidsvurderingene?
Uenigheten handler både om hva som skal oppnås, og om hvor sterke tilbakekoblingene blir. Her er tre daterte innfallsvinkler. De vurderer ulike milepæler og bygger på ulike antakelser, så tallene kan ikke slås sammen til ett «ekspertanslag».
| Avsender og dato | Hva vurderes? | Tidsbilde | Hva driver vurderingen? |
|---|---|---|---|
| AI 2027-forfatterne, april 2025 | Et mulig forløp med automatisert forskning og superintelligens. | Scenarioet utforsker rask utvikling gjennom 2027, ikke en medianprognose. | KI bidrar til videre KI-forskning; fremgangen forsterker seg. Alternative forløp inngår.11 |
| AI Futures Model, oppdatert 16. august 2026 | Full automatisering av programmeringsarbeidet i et KI-utviklingsprosjekt, Automated Coder (AC). | Modellmedianer: Daniel Kokotajlo desember 2027, Brendan juli 2028, Eli mars 2029. Dette er en smalere milepæl enn superintelligens. | Ulike forutsetninger om koding, beregningskraft, forskning og oppskalering. Modellens endringslogg skiller medianene fra en enkelt simulert bane.12 |
| Ege Erdil, april 2025 | Full automatisering av arbeid som kan utføres på avstand. | Omtrent 20 år fra artikkelens dato som hans medianvurdering. Ikke et oppdatert konsensusanslag. | Større vekt på eksperimenter, data, maskinvare og begrensninger ved praktisk automatisering.13 |
Rask fremgang på en test avgjør ikke alene hvem som får rett. For å følge utviklingen er det mer nyttig å undersøke om systemene mestrer lengre oppgaver, om de gjør faktisk arbeid raskere, og om de bidrar til bedre forskning.
Hvor sikre kan vi være? Testene viser tydelig fremgang på avgrensede oppgaver. Det er mer usikkert hvor godt resultatene overføres til praktisk arbeid, hvor pålitelige systemene blir og hvor raskt utviklingen fortsetter. Grafene over er øyeblikksbilder av bestemte målinger, ikke en prognose for katastrofe.
Les mer
METRs måleside viser det bredere utvalget og oppdateringene. AI Futures Model synliggjør antakelser bak prognoser. Erdils analyse forklarer argumentet for lengre tidslinjer. METRs oppfølging av utviklerstudien viser hvorfor måling i faktisk arbeid er krevende.
Videre
Neste spørsmål: Hvorfor gjør ikke en flinkere KI alltid det vi ønsker?
Lurer du på en test eller en påstand om KI? Send spørsmålet til Tryggere KI eller finn Discord-samtalen. Se også hva sikkerhetsarbeidet består i.
Kilder og noter
OpenAI: Learning to reason with LLMs, 12. september 2024, vedlegg A, pass@1. Tallene 9,3, 44,6 og 74,4 hører til samme tabellrad. Andre oppsett og antall forsøk har andre resultater. Lokalt datagrunnlag:
data/aime_2024.json.↩1↩2Google DeepMind, 21. juli 2025. Avansert forskningsversjon, naturlig språk, konkurransens tidsramme og offisiell bedømming.↩
OpenAI, 8. september 2026, og Clay, 11. september 2026. Kunngjort løsning av formuleringen med ytre kraft; fleragentsystem og formell verifikasjon. Ingen egen beviskontroll eller avsluttet prisvurdering påstås.↩
METRs måleside. Oppgaver hovedsakelig innen programvare, maskinlæring og datasikkerhet, med lite forhåndskontekst og avgrensede suksesskriterier. Modellen kombineres med verktøy og et agentoppsett; testen måler ikke en hel jobb.↩
METRs offisielle TH1.1-data og metodebeskrivelsen. Ti poster fra TH1.1, ikke blandet med TH1.0. Utvalget er manuelt overført fra indeksert innhold på METRs offisielle dataadresse til
data/metr_th11_selection.json. Dette er ikke en ny beregning av METRs estimater. METRs FAQ har et annet GPT-5-eksempel; her brukes konsekvent posten fra TH1.1-datafilen. Kilden advarer om målinger over 16 timer; de brede intervallene er beholdt. Målesiden er merket 8. mai 2026, kildeuttaket er fra 19. september.↩1↩2↩3↩4METR, 10. juli 2025. Randomisert studie med 16 erfarne utviklere og 246 oppgaver i kjente kodebaser; verktøy fra tidlig 2025. Resultatet gjelder dette utvalget, ikke alle utviklere eller alle senere verktøy.↩
METR, 24. februar 2026. Oppfølgingen beskriver seleksjon av deltakere og oppgaver og vansker med å måle tidsbruk. De nye tallene er derfor ikke tegnet som en direkte fortsettelse av 2025-resultatet.↩
Dell'Acqua mfl.: Navigating the Jagged Technological Frontier. Skjemategningen er vår forklaring, ikke data fra studien.↩
Carlsmith drøfter mulig overmenneskelig kapasitet; Erdil drøfter flaskehalser. Ingen av dem gir en universell øvre grense.↩
OpenAI: Research acceleration, 6. september 2026. Leverandørens beskrivelse av eget arbeid.↩
AI 2027, publisert april 2025 med senere merknader. Scenario, ikke observasjon eller fast kalenderprognose.↩1↩2
AI Futures Models daterte prognoseside og endringslogg, oppdateringen 16. august 2026. Medianer for AC, ikke for ASI og ikke datoene fra modellen kjørt én gang med medianparametere. Opplysningene er lest fra sidens indekserte tekst, ikke beregnet på nytt.↩
Ege Erdil, 26. april 2025. Personlig medianvurdering for full automatisering av fjernarbeid; annen milepæl og annen vurderingsdato enn AC-prognosene.↩